理解虚拟内存:程序看到的地址为什么不是真实内存
当前位置:点晴教程→知识管理交流
→『 技术文档交流 』
本文深入梳理了虚拟内存如何解决进程隔离问题并构建独立受控的地址空间视图。常见 x86-64 模式下虚拟地址可达二百五十六TiB,却仅需实际映射部分对应真实物理内存资源。
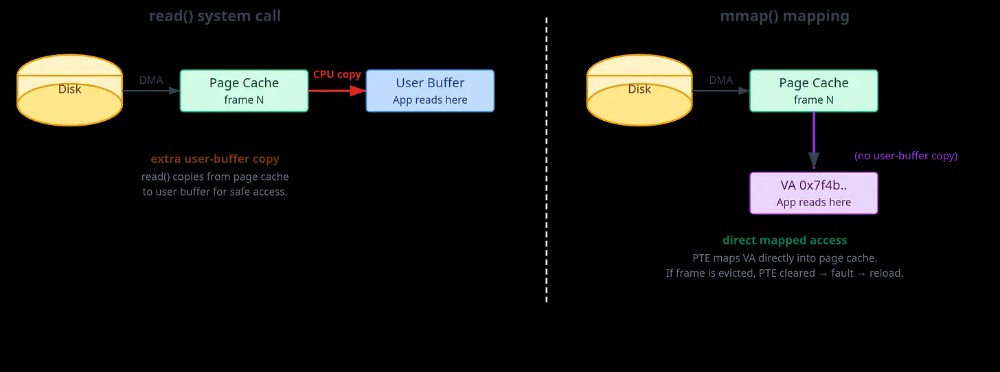
内核通过按需分页与写时复制机制优化内存分配,并利用 mmap 减少文件读取时的数据拷贝从而提升 I/O 速度。 这几天学习了「《Virtual Memory: A Deep Dive into Page Tables, TLBs, and Linux Internals》」里面关于虚拟内存的知识,这篇文章我们来聊聊一个操作系统里的基础概念:虚拟内存。 学过「操作系统」的小伙伴可能知道,进程运行时看到的地址,并不一定等同于真实的物理内存地址。它看到的是一套由操作系统和硬件共同维护的虚拟地址空间。CPU 访问内存时,还需要通过页表、TLB 等机制,把虚拟地址翻译成物理地址。 原文讲得很细,从虚拟地址空间、页表、TLB、缺页异常,一路讲到 为什么程序不能直接使用真实内存?我们知道日常工作中,一台电脑会经常同时开着浏览器、编辑器、终端,连着数据库,以及跑着一堆后台进程。如果每个程序都直接拿着物理内存地址读写,就会遇到两个问题:第一,程序之间如何协调。程序 A 不知道程序 B 是否占用了某块物理内存,如果两个程序直接读写同一块物理地址,就可能互相覆盖数据,导致程序异常甚至系统不稳定。第二,安全性很差。程序 A 中的普通 bug,可能直接修改甚至破坏另一个程序的数据,导致程序异常。 所以,操作系统开始给每个进程安排了一套自己的“地址空间”。在进程眼里,它好像拥有一大片独立内存;但在操作系统眼里,这些地址还需要再翻译成真正的物理内存位置。 这就是虚拟内存的核心作用:让每个进程看到一套独立、受控、可管理的内存视图。 进程看到的内存布局一个进程的虚拟地址空间通常会被分成几个区域:代码段、数据段、BSS、堆、内存映射区域、栈,以及内核保留区域。每个区域的分工如下:
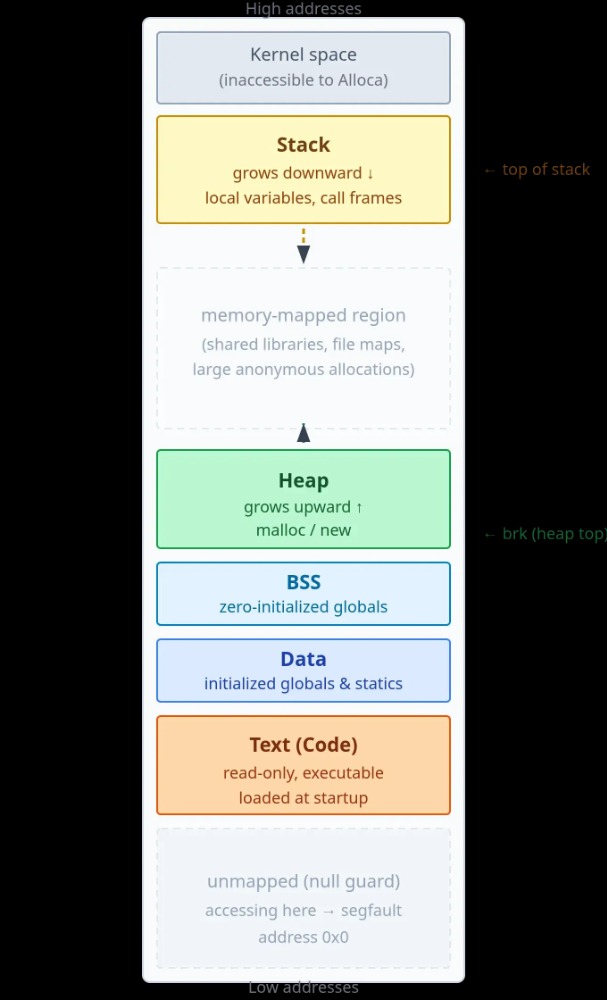 上图就是各区域分工的直观体现,我们可以看到 Stack、Heap、BSS、Data、Text / Code、memory-mapped region 在地址空间里的位置。 在常见的 48-bit x86-64 虚拟地址模式下,虚拟地址最多可以表示 2^48 个字节位置,也就是 256 TiB 的地址空间。这里的 256 TiB 指的是“可寻址范围”,不代表机器真的有这么多物理内存。Linux 通常会把这段虚拟地址空间分成两部分:低地址区域留给用户态进程,高地址区域用于内核映射。对应到上图,就是 low address 和 high address。 这也变相地解释了一个常见疑问:为什么一台只有 16GB / 32GB 内存的机器,进程却能拥有远大于物理内存容量的虚拟地址空间。虚拟地址空间的大小和真实 RAM 容量,本就是两码事。虚拟地址的空间可以很大,但只有被进程实际使用、并且建立了有效页表映射的部分,才会进一步对应到物理内存或页缓存中的数据页。 地址翻译的基本过程下面轮到页表出场了。 操作系统不会按“每一个字节”去管理映射关系,那样太细、太繁琐了。它通常按页来管理。常见的页面大小是 4KB。虚拟地址空间被切成一页一页的虚拟页,物理内存也被切成一块一块的页框。 当程序访问一个虚拟地址时,CPU 里的 MMU,也就是内存管理单元,会根据页表把它翻译成物理地址。在 x86-64 的四级页表结构中,虚拟地址会被拆成多个字段,分别用于索引 PGD、PUD、PMD、PTE,最后 12 位作为页内偏移。
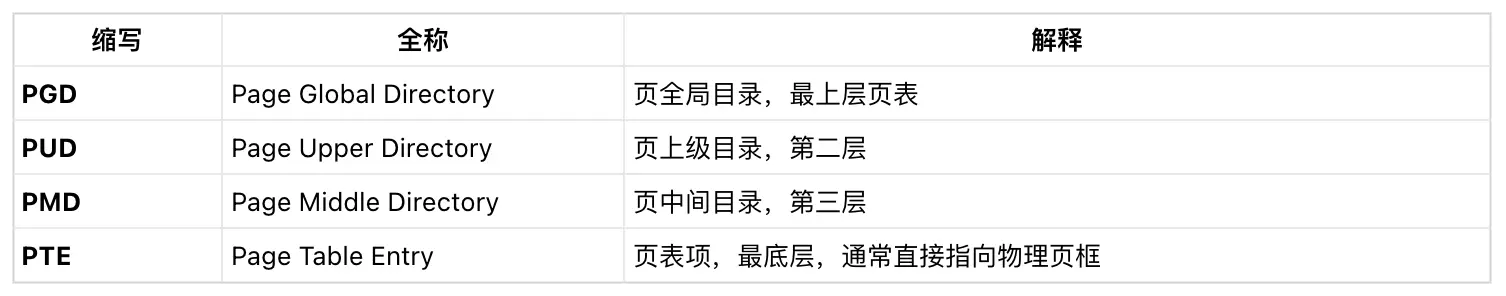
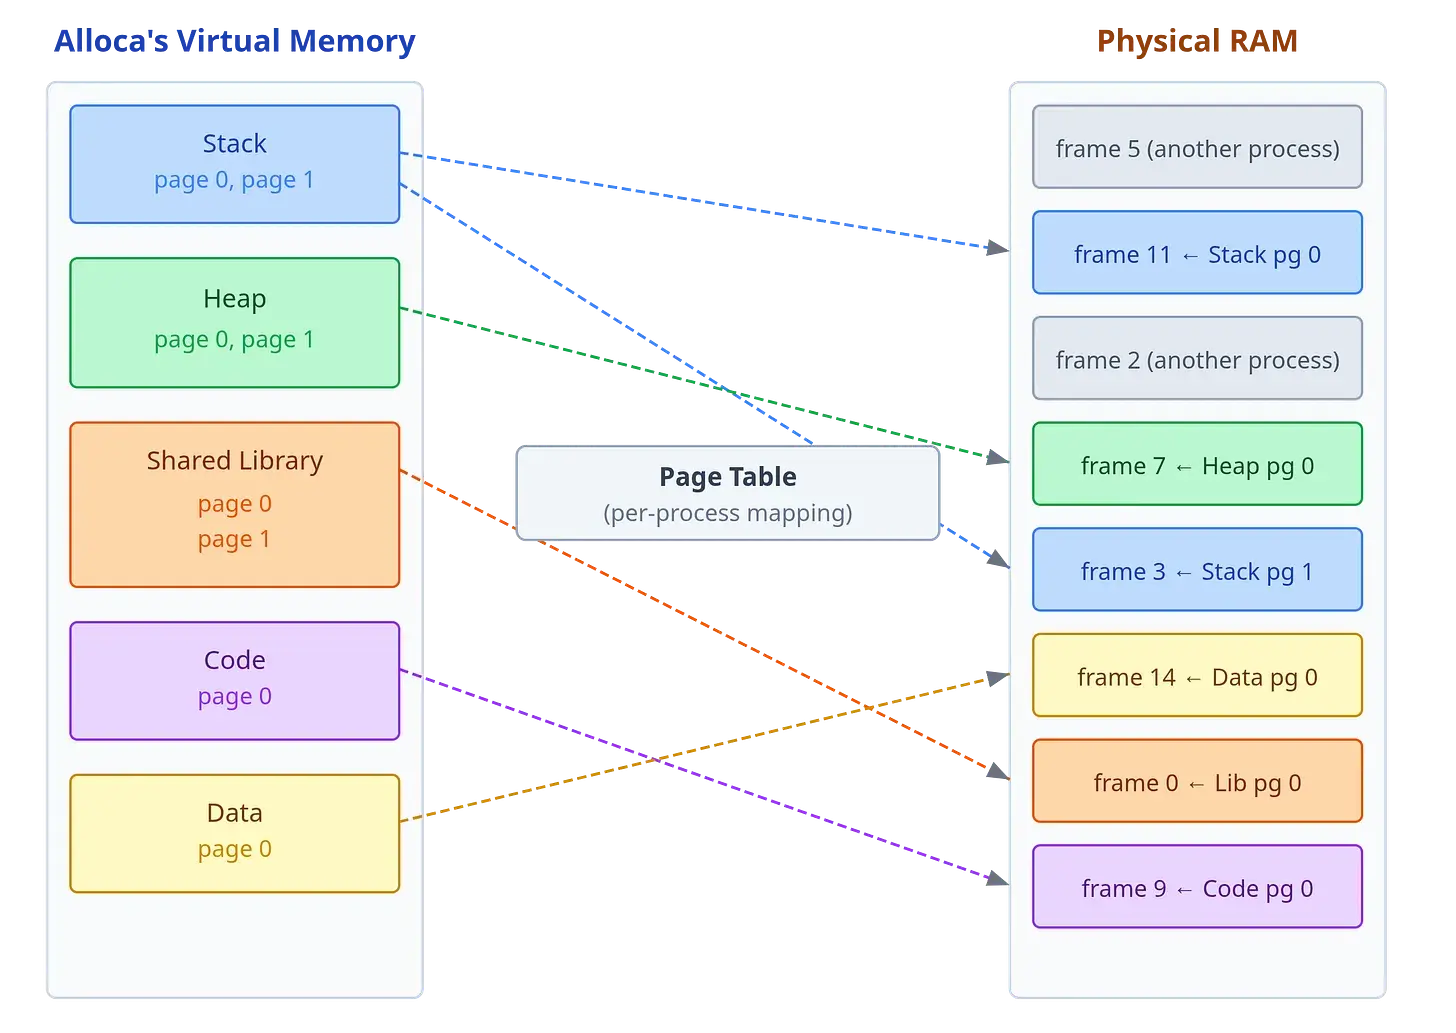
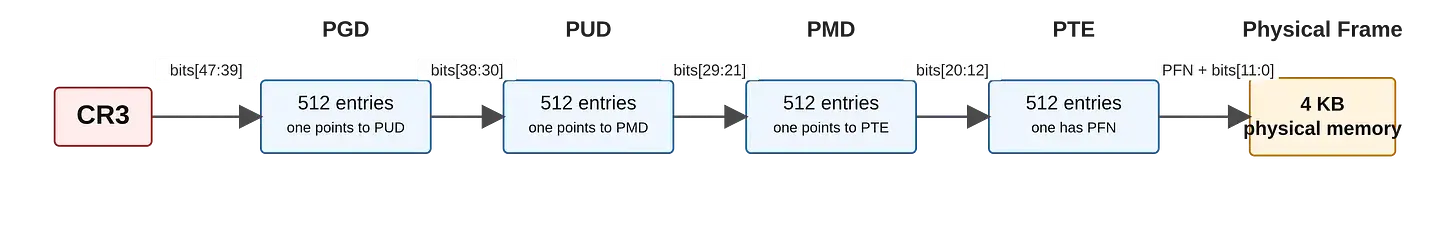
寻址过程: 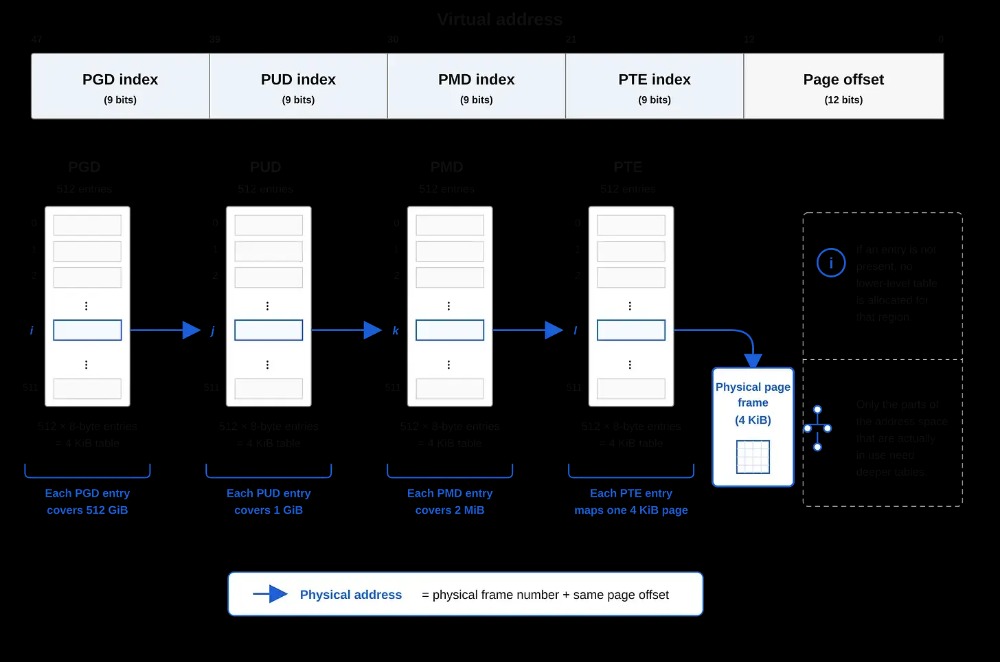 上图解释了“一个虚拟地址是怎么被拆开,并逐级查表的”。把它想成查地图的话,大概流程就是:先用第一段地址信息找到大区 PGD;再用第二段找到街区 PUD;再用第三段找到楼 PMD;最后用第四段找到房间 PTE;最后的页内偏移告诉你具体是哪一个字节。 这样做的好处是:不用为整个巨大地址空间提前准备一张完整大表。只有真正用到的区域,才需要建立相应的页表结构。页表的层级是稀疏的,只为实际使用的地址空间分配结构,避免平铺页表带来的巨大开销。 连续地址背后的物理映射这是虚拟内存里很重要的一点。程序看到的数组可能是连续地址。但这些虚拟页映射到物理内存时,可以分散在不同位置。程序并不需要知道这些细节。它只看到一段连续空间;页表负责把这些虚拟页指向真实的物理页框。
这个图解释了什么叫“程序看到连续,物理上可以分散”。物理映射也是虚拟内存让系统更灵活的地方。操作系统可以把不同进程的物理页框交错放在 RAM 里,同时保证每个进程看到的仍然是一套干净、连续、独立的地址空间。上图就在说这一点:相邻虚拟页可以落在相距很远的物理页框中,不同进程的页框也可以交错分布在物理内存里。 TLB:地址翻译的缓存层每次访问内存都查页表,会不会很慢?答案是:会。所以硬件还准备了一个缓存:TLB(全称:Translation Lookaside Buffer,地址转换后备缓冲器)。 TLB 可以理解成“地址翻译缓存”。如果某个虚拟页到物理页框的映射刚刚查过,MMU(全称:Memory Management Unit,内存管理单元)下次就可以先查 TLB。命中之后,不需要完整走一遍页表。TLB 会自行缓存已经完成的地址翻译;只有 TLB 未命中时,MMU 才需要进行完整的页表遍历。程序的访问模式会显著影响 TLB 命中率。小工作集、重复访问的循环、复用的缓冲区,通常更容易保持 TLB 友好。
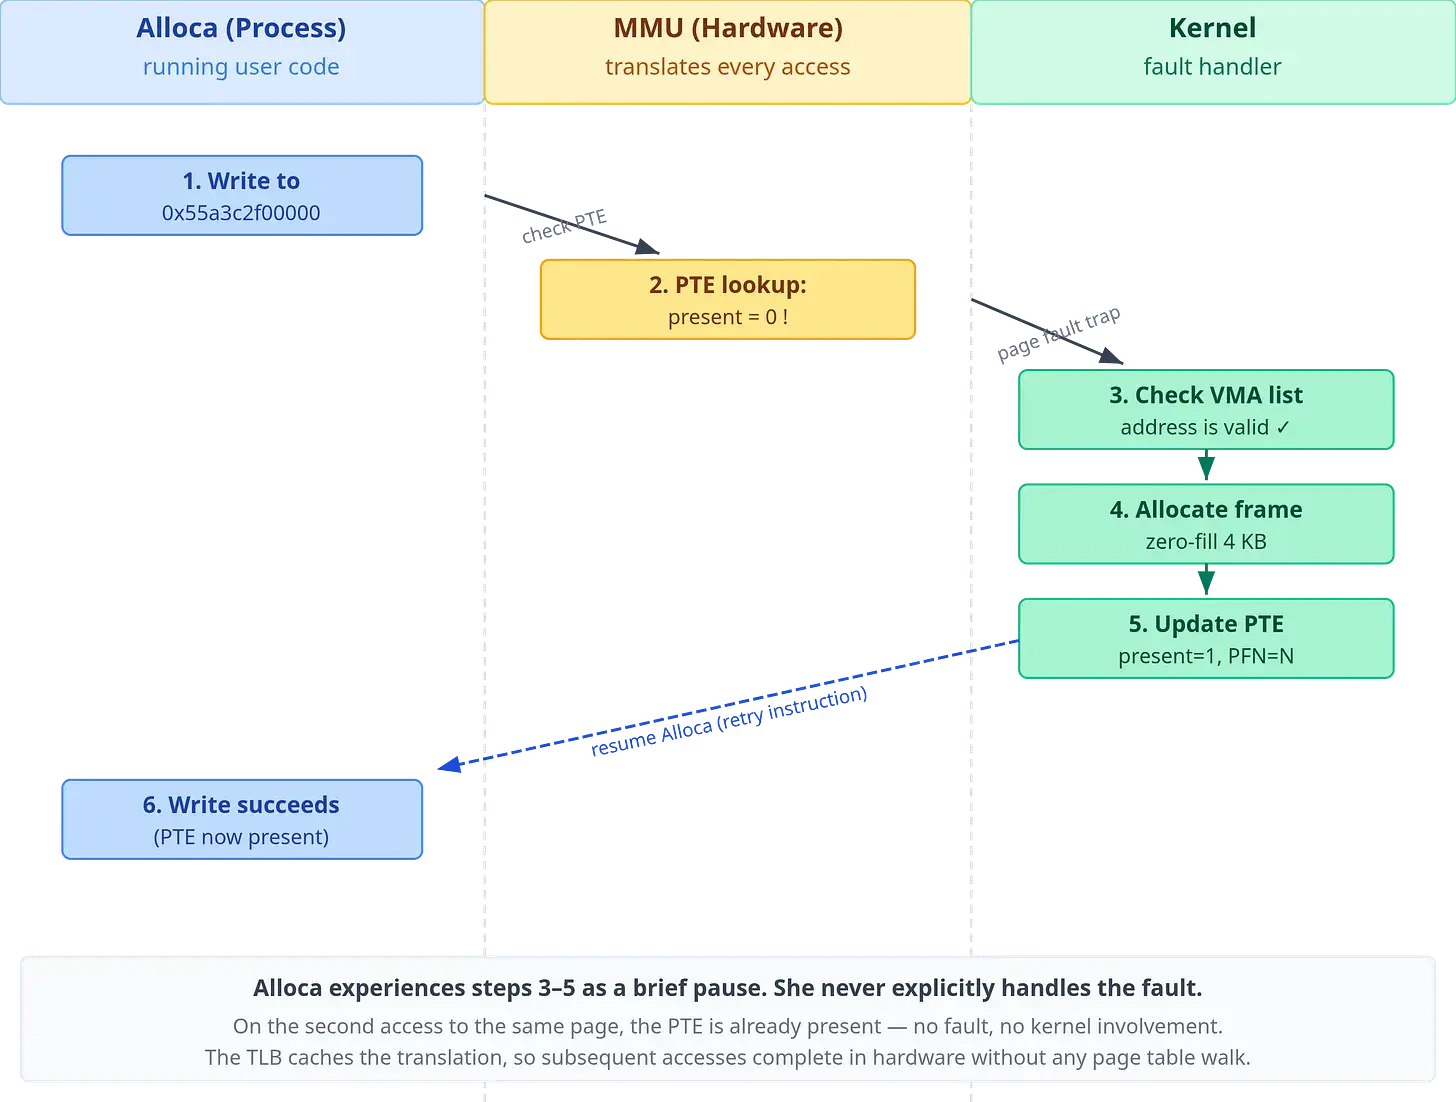
上图展示了 CR3 和四级页表遍历的大致路径。结合 TLB 来看,它也能解释为什么内存访问模式会影响性能:同样是读数据,顺序访问、局部性好的访问,往往比到处跳着访问更友好。 内存申请背后的按需分配可能会有人以为,程序一申请内存,操作系统就立马分配对应的物理内存。实际上,操作系统会更懒一点。 操作系统可以先给你一段合法的虚拟地址范围,等你真正访问它时,再分配物理页框。这叫 demand paging,也就是按需分页。 比如程序调用
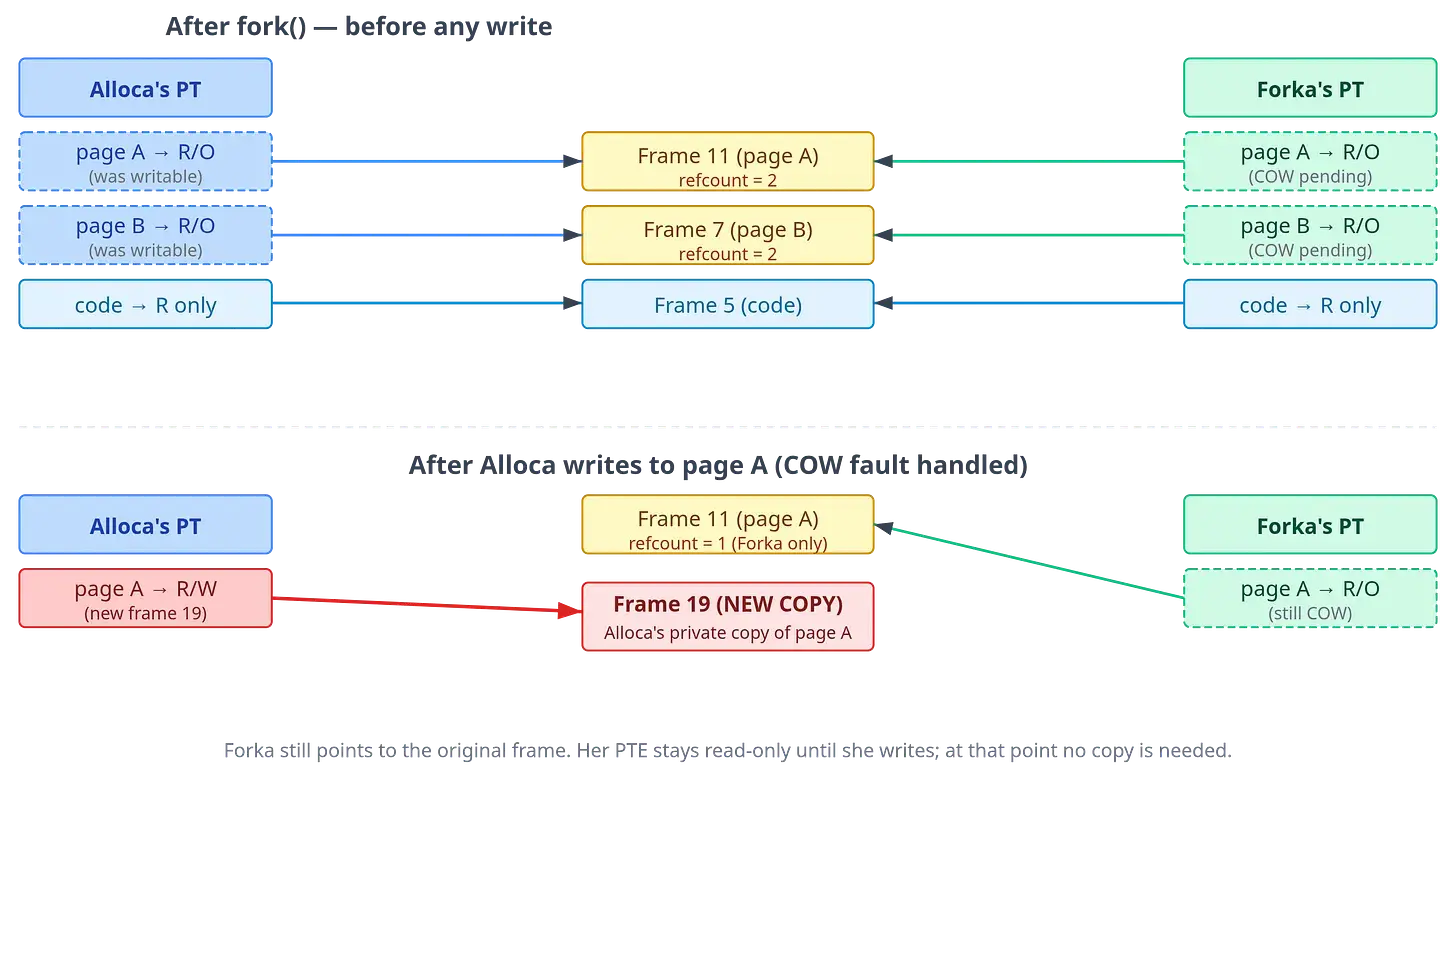
上图为“程序访问 → MMU 发现 present=0 → 内核处理 → 更新 PTE → 程序继续运行”整个流程是如何运作的。有时候,我们的程序会看起来申请了很多内存,但实际 RSS(全称:Resident Set Size,常驻集大小)没有立刻涨那么多。因为虚拟地址可以先被预留出来,物理页框往往等到真正访问时才会分配并建立映射。 写时复制背后的进程复制虚拟内存还支撑了一个很经典的机制:copy-on-write,写时复制。 在 Unix/Linux 系统里, 它会让父进程和子进程先共享同一批物理页,并把相关页标记成只读。等其中一个进程真的要写某一页时,CPU 再触发权限异常。然后内核来复制那一页,给写入方一份私有副本。 下图展示了这个过程:
这个机制让
|
关键字查询
相关文章
正在查询... 
|


 400 186 1886